BPMN для оркестрации LLM
Представьте, что вы попросили AI написать функцию на Go. Он вернул код. Можно скопировать его в проект, но сначала хочется проверить: решает ли он задачу, нет ли ошибок, ничего ли не забыто? Попросим другую модель побыть проверяющим. Если она найдёт проблемы, вернём замечания первой модели.
Получается небольшой процесс: написать → проверить → при необходимости исправить и проверить ещё раз. Но что делать, если модели долго не отвечают? Сколько раз разрешать исправления? Когда позвать человека?
Управление таким порядком действий называют оркестрацией. В этом примере за неё отвечает go-bpm. Он вызывает модели, сохраняет ход работы в PostgreSQL и решает, какой шаг выполнить дальше. LLM — большая языковая модель: здесь она пишет текст и код или проверяет чужой ответ. BPMN — способ нарисовать процесс: блоки обозначают задачи, а стрелки показывают порядок их выполнения.
Мы собрали учебный проект go-bpm-ai-orchestrator и проверили его на настоящих моделях. В одном запуске модель исправляла код по замечаниям. В другом она не успела ответить, и задача перешла человеку. При этом обнаружилась важная проблема: проверяющая модель одобрила код, который не компилируется. Ниже разберём и работу процесса, и эту ошибку.
Исходный код и запуск · BPMN-схема · Журнал эксперимента
Зачем нужен отдельный процесс#
Первую версию можно написать обычными вызовами из Go: отправить запрос одной модели, затем другой,
проверить ответ через if, при необходимости повторить в цикле. Для короткого эксперимента этого достаточно.
В нашем примере нужно ещё хранить черновик и замечания, считать попытки, следить за временем и ждать решения человека. Эти правила мы описали в BPMN. По схеме видно, куда пойдёт задача после каждого ответа, а в истории — какие шаги уже выполнены. Данные сохраняются в базе, поэтому ход работы можно восстановить после перезапуска приложения.
Например, ограничение «не больше трёх попыток» проверяет программа. Модели не нужно помнить о нём или самой решать, пора ли остановиться.
Идея эксперимента появилась после статьи Niall Deehan Why AI Agents Need Orchestration в блоге Camunda. В нашем примере две модели работают последовательно, а человек подключается, если закончилось время или не удалось получить одобрение за разрешённое число попыток.
Как задача проходит по схеме#
Допустим, пользователь просит написать функцию, которая сортирует числа и убирает повторы. Дальше происходит следующее:
- Исполнитель получает задание и пишет первый вариант решения — черновик.
- Рецензент получает исходное задание и черновик. Он либо одобряет ответ, либо возвращает замечания.
- Если ответ одобрен, процесс завершается. Если есть замечания, исполнитель получает их вместе с прошлым черновиком и готовит новую версию.
- Если попытки закончились или модель не успела ответить, процесс создаёт задачу «Нужен человек» и ждёт решения пользователя.
Один проход через исполнителя и рецензента будем называть итерацией. По умолчанию разрешены три таких прохода.
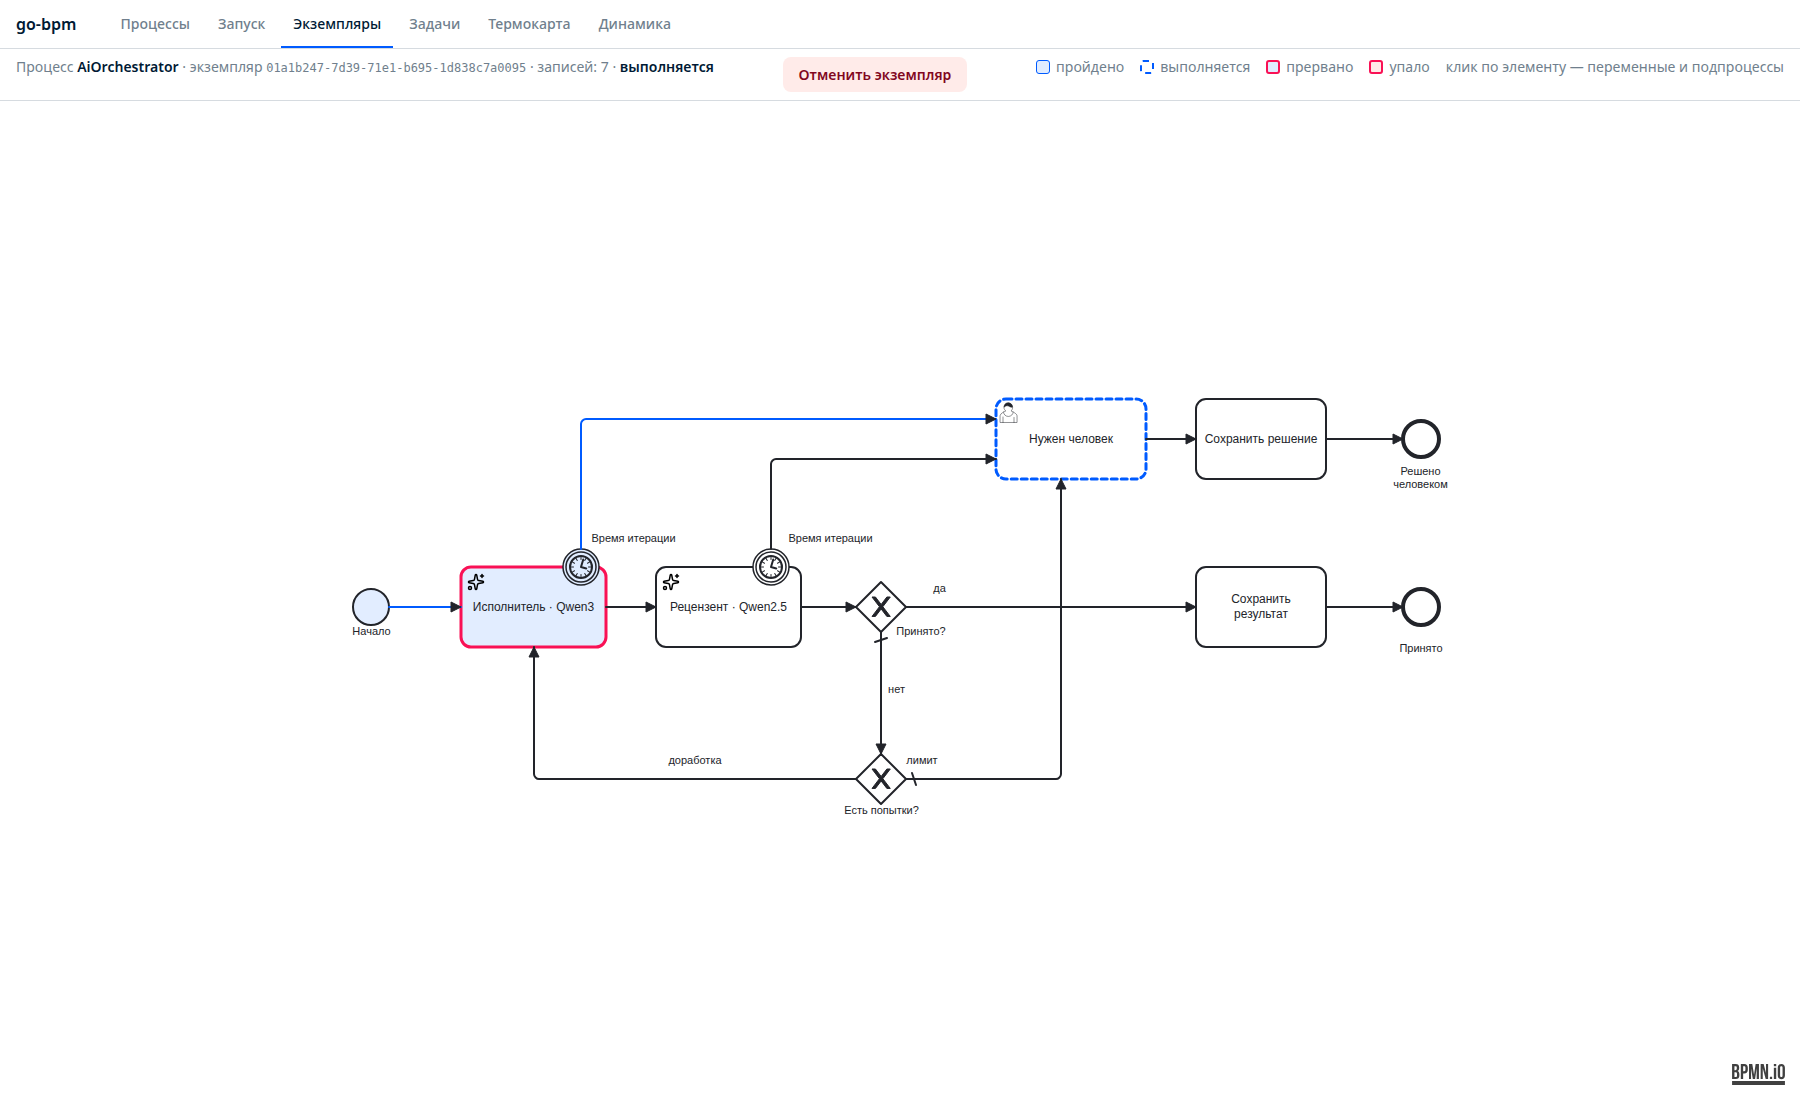
На этом снимке исполнитель не успел ответить вовремя. Таймер прервал его задачу, синяя ветка привела к человеку, а пунктирная рамка показывает, что процесс ждёт его решения. Открыть схему в полном размере.
Модели в этом проекте только возвращают текст. Они не запускают команды, не меняют файлы и не работают с GitHub. Сборка кода, тесты и публикация приложения в этот процесс пока не входят.
Где находятся вспомогательные действия в коде
Счётчик итераций и причину передачи человеку обновляют обработчики переходов из пакета
internal/orchestration. Они выполняются, когда процесс проходит по соответствующим стрелкам.
Приложение подключает их через orchestration.Processes(svc).
Поэтому отдельные блоки «Следующая итерация», «Лимит исчерпан» и «Таймаут AI» на схеме не нужны.
Как модели обмениваются результатами#
| Роль | Модель на стенде | Что получает | Что возвращает |
|---|---|---|---|
| Исполнитель | qwen3-coder:30b-32k | Цель, предыдущий черновик и замечания | Текст решения в draft |
| Рецензент | qwen2.5-coder:32b-8k | Цель и последний черновик | JSON с approved и feedback |
Модели работают через Ollama — программу для запуска языковых моделей. У каждой роли есть своя инструкция: одна просит подготовить решение, другая — проверить его. Общего чата у моделей нет: приложение само передаёт нужные данные при каждом запросе.
Чтобы программа могла понять ответ рецензента, он возвращает JSON с двумя полями: approved — одобрен ли черновик,
feedback — комментарий. Например:
{
  "approved": false,
  "feedback": "Проверь обработку nil и убедись, что входной срез не изменяется."
}
Код обращения к модели передаёт описание нужного формата — JSON Schema — и проверяет полученный ответ.
Поле approved должно содержать true или false, а feedback — непустой текст.
Если модель вернула сломанный JSON, программа не может узнать её решение. Это ошибка запроса,
а не замечание к черновику.
Какие модели и оборудование использовали
На стенде используется RTX 3090 с 24 ГБ памяти. Для Qwen3 подтверждена загрузка всех 49 слоёв на GPU
и контекст 32768. Рецензент настроен на контекст 8192. Адаптер наследует параметры Modelfile,
вызовы идут последовательно, keep_alive: 0 освобождает память после ответа.
Две большие модели не нужно держать в GPU-памяти одновременно. Это описание конфигурации эксперимента, а не замер скорости.
Что делать с замечаниями, ошибками и долгим ожиданием#
Здесь важно различать три ситуации. «Код нужно исправить», «запрос сломался» и «мы слишком долго ждём» требуют разных действий.
| Механизм | Когда включается | Что происходит |
|---|---|---|
| Доработка | Рецензент вернул approved: false | Новая итерация с замечаниями, до лимита maxRounds |
| Технический повтор | Ошибка HTTP, пустой, обрезанный или некорректный ответ | Очередь повторяет AI-задачу; настроены 2 попытки |
| Истечение срока | Истёк общий срок итерации | AI-задача прерывается в BPMN, создаётся задача человека |
| Ручное решение | Истёк срок или исчерпаны итерации | Процесс ждёт пользователя группы reviewers |
По умолчанию разрешены 3 итерации, допустимый диапазон maxRounds — от 1 до 5.
У пары «исполнитель + рецензент» общий срок на один проход: aiTimeoutSeconds, по умолчанию 120 секунд, диапазон от 1 до 600.
Рецензент использует оставшееся время этой же итерации. При возврате на доработку срок начинается заново.
Например, если исполнитель потратил 90 секунд из разрешённых 120, на проверку остаётся 30 секунд.
Оба таймера на схеме используют одну дату окончания — переменную iterationDeadline.
Для наглядного прогона поставили 5 секунд и запросили развёрнутую реализацию конкурентного LRU-кеша.
Исполнитель не успел: процесс перешёл к человеку, не ожидая окончания генерации.
Прерывание ветки BPMN не гарантирует остановку вычисления в Ollama. Уже начатый HTTP-запрос может завершиться позже. Движок отбрасывает его запоздалый результат: он не возобновляет прерванную ветку и не перезаписывает ручное решение. Технический таймаут HTTP-попытки — 10 минут; это отдельное ограничение.
Как начинается итерация и проверяется её лимит
Обработчик входящего перехода к исполнителю проверяет параметры, увеличивает счётчик и записывает срок. Это снимок рукописного кода проекта:
// go-bpm-ai-orchestrator/prepare.go.txt
func prepare(ctx context.Context, svc *services.Services, data *model.DataModel) error {
	if data.MaxRounds == 0 {
		data.MaxRounds = 3
	}
	if data.MaxRounds < 1 || data.MaxRounds > 5 {
		return fmt.Errorf("maxRounds must be between 1 and 5")
	}
	if strings.TrimSpace(data.Goal) == "" {
		return fmt.Errorf("goal is required")
	}
	if data.AITimeoutSeconds == 0 {
		data.AITimeoutSeconds = 120
	}
	if data.AITimeoutSeconds < 1 || data.AITimeoutSeconds > 600 {
		return fmt.Errorf("aiTimeoutSeconds must be between 1 and 600")
	}
	data.IterationDeadline = time.Now().Add(time.Duration(data.AITimeoutSeconds) * time.Second).UTC().Format(time.RFC3339Nano)
	data.Round++
	return nil
}
Условие шлюза сгенерировано из BPMN:
// go-bpm-ai-orchestrator/cond_limit.go.txt
// limit возвращает id следующего элемента после Limit
func limit(data *model.DataModel) string {
	// в процессе: round < maxRounds
	if data.Round < data.MaxRounds {
		return "again"
	}
	return "stop"
}Как человек принимает решение#
Когда автоматика не справилась, процесс не заканчивается. Он создаёт задачу в веб-консоли go-bpm
и ждёт пользователя из группы reviewers. Пользователь может принять результат или отклонить его
и оставить комментарий.
Каждый отдельный запуск процесса называется экземпляром. Пока он ждёт человека, его статус —
running («выполняется»), а результат outcome — needs_human («нужен человек»).
В переменной escalationReason записана причина: ai_timeout — закончилось время,
iteration_limit — закончились попытки.
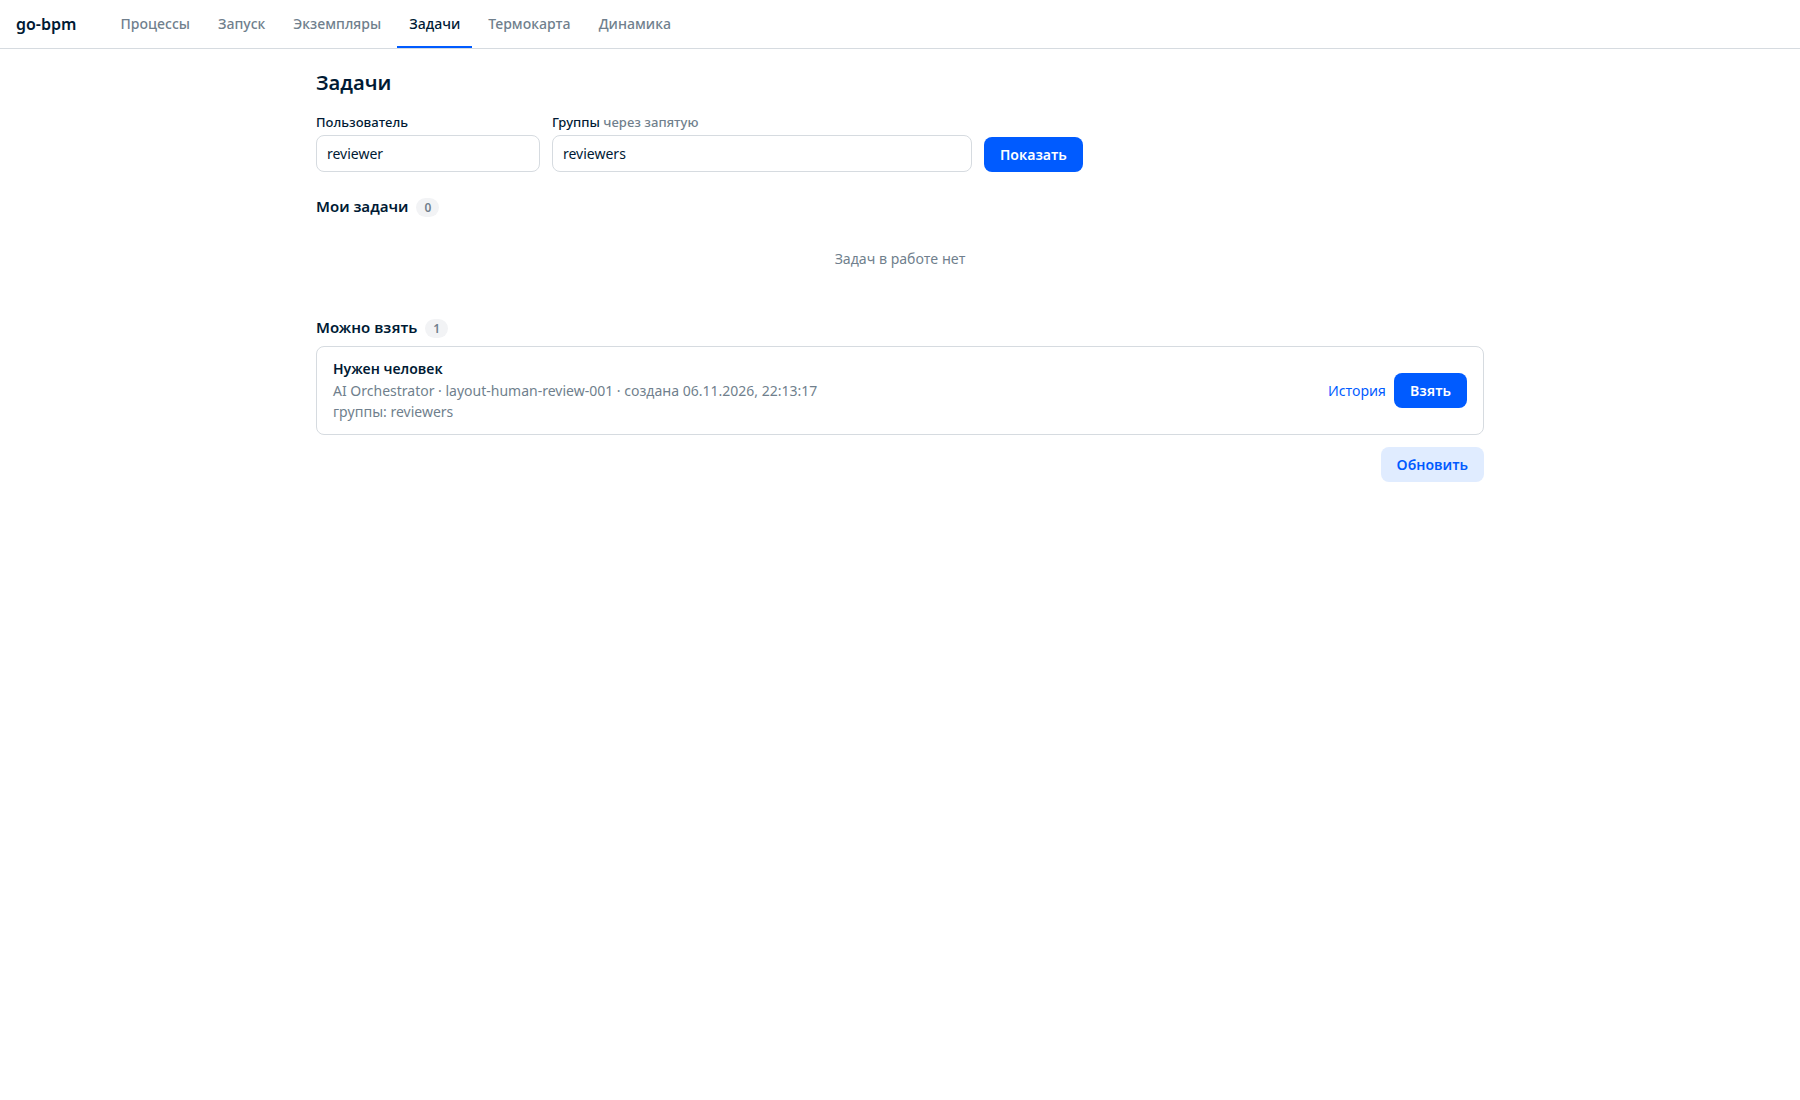
Открыть очередь задач в полном размере.
В нашем прогоне пользователь reviewer взял задачу, открыл «Выполнить» и передал решение с комментарием:
{
  "humanApproved": false,
  "humanComment": "AI превысил срок итерации. Результат отклонён, требуется отдельный повтор после проверки задания."
}
Отдельная форма для этого не создавалась: используется обычный редактор переменных go-bpm. Результат можно заполнить полями или JSON.
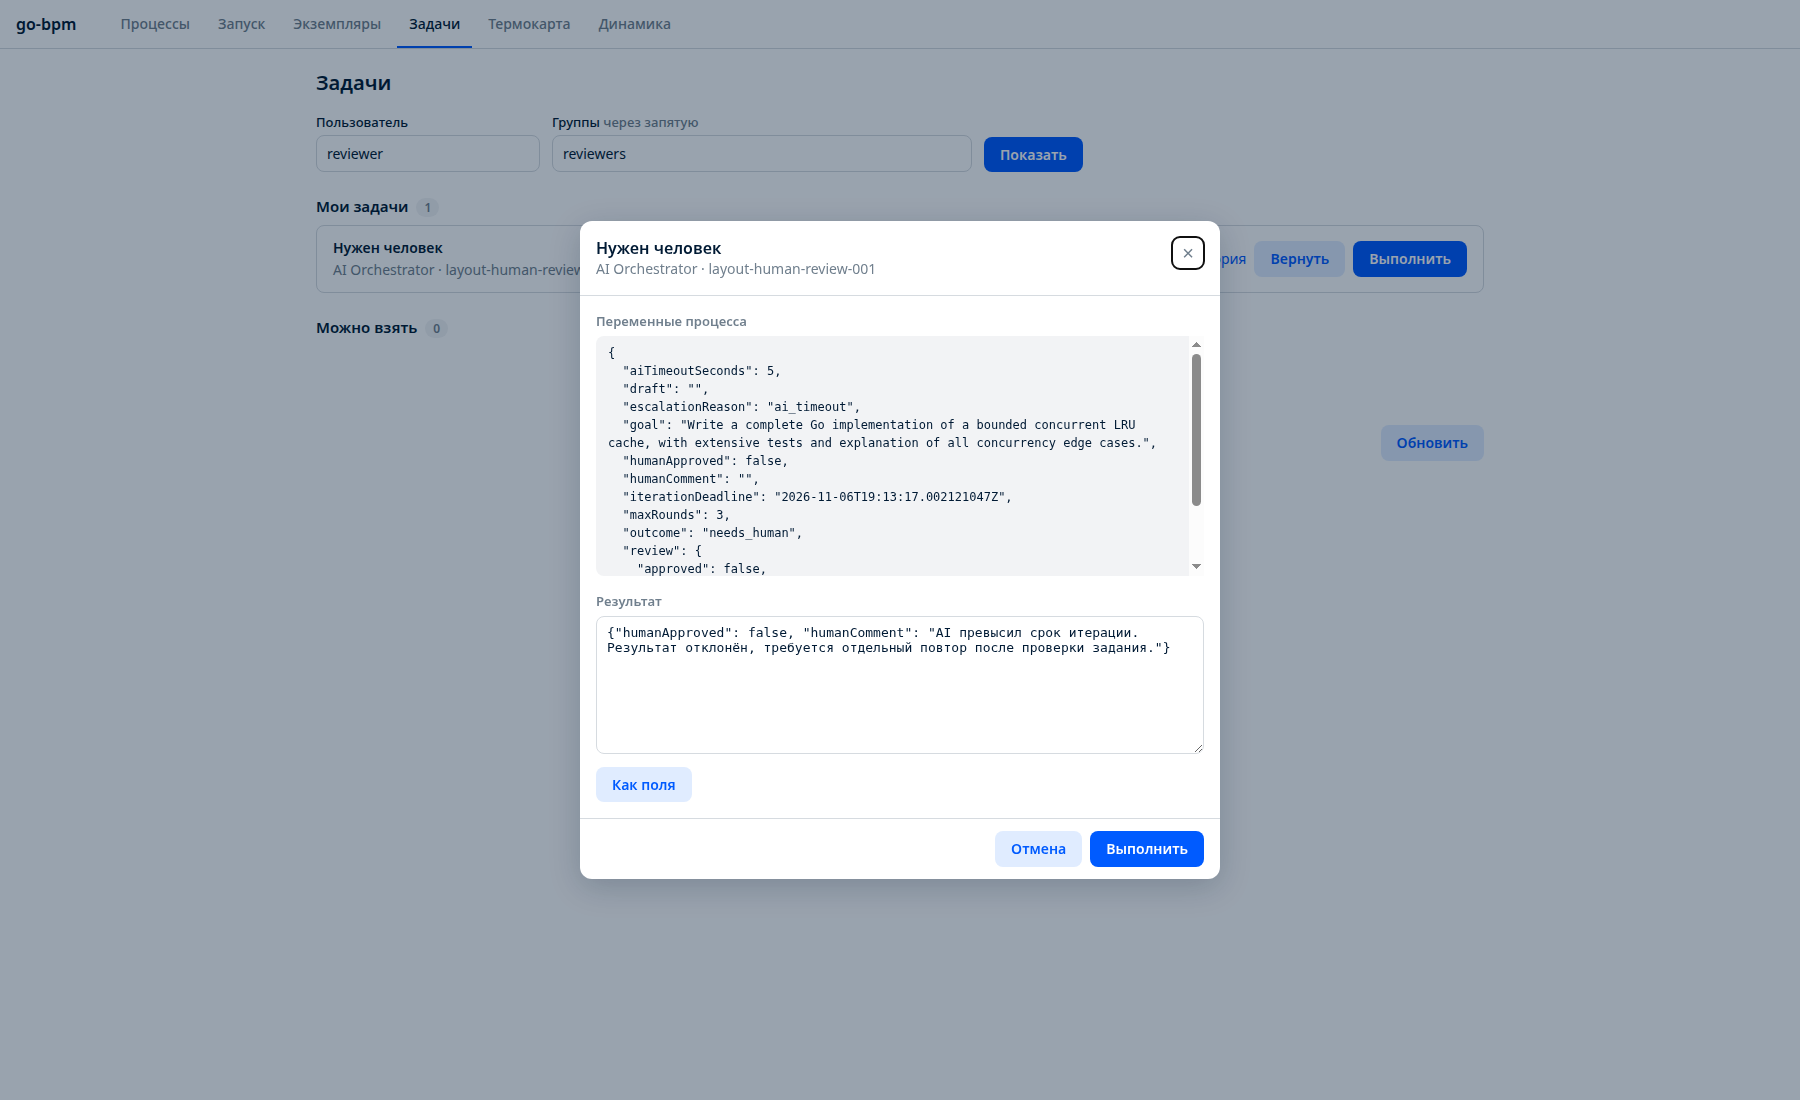
Открыть решение человека в полном размере.
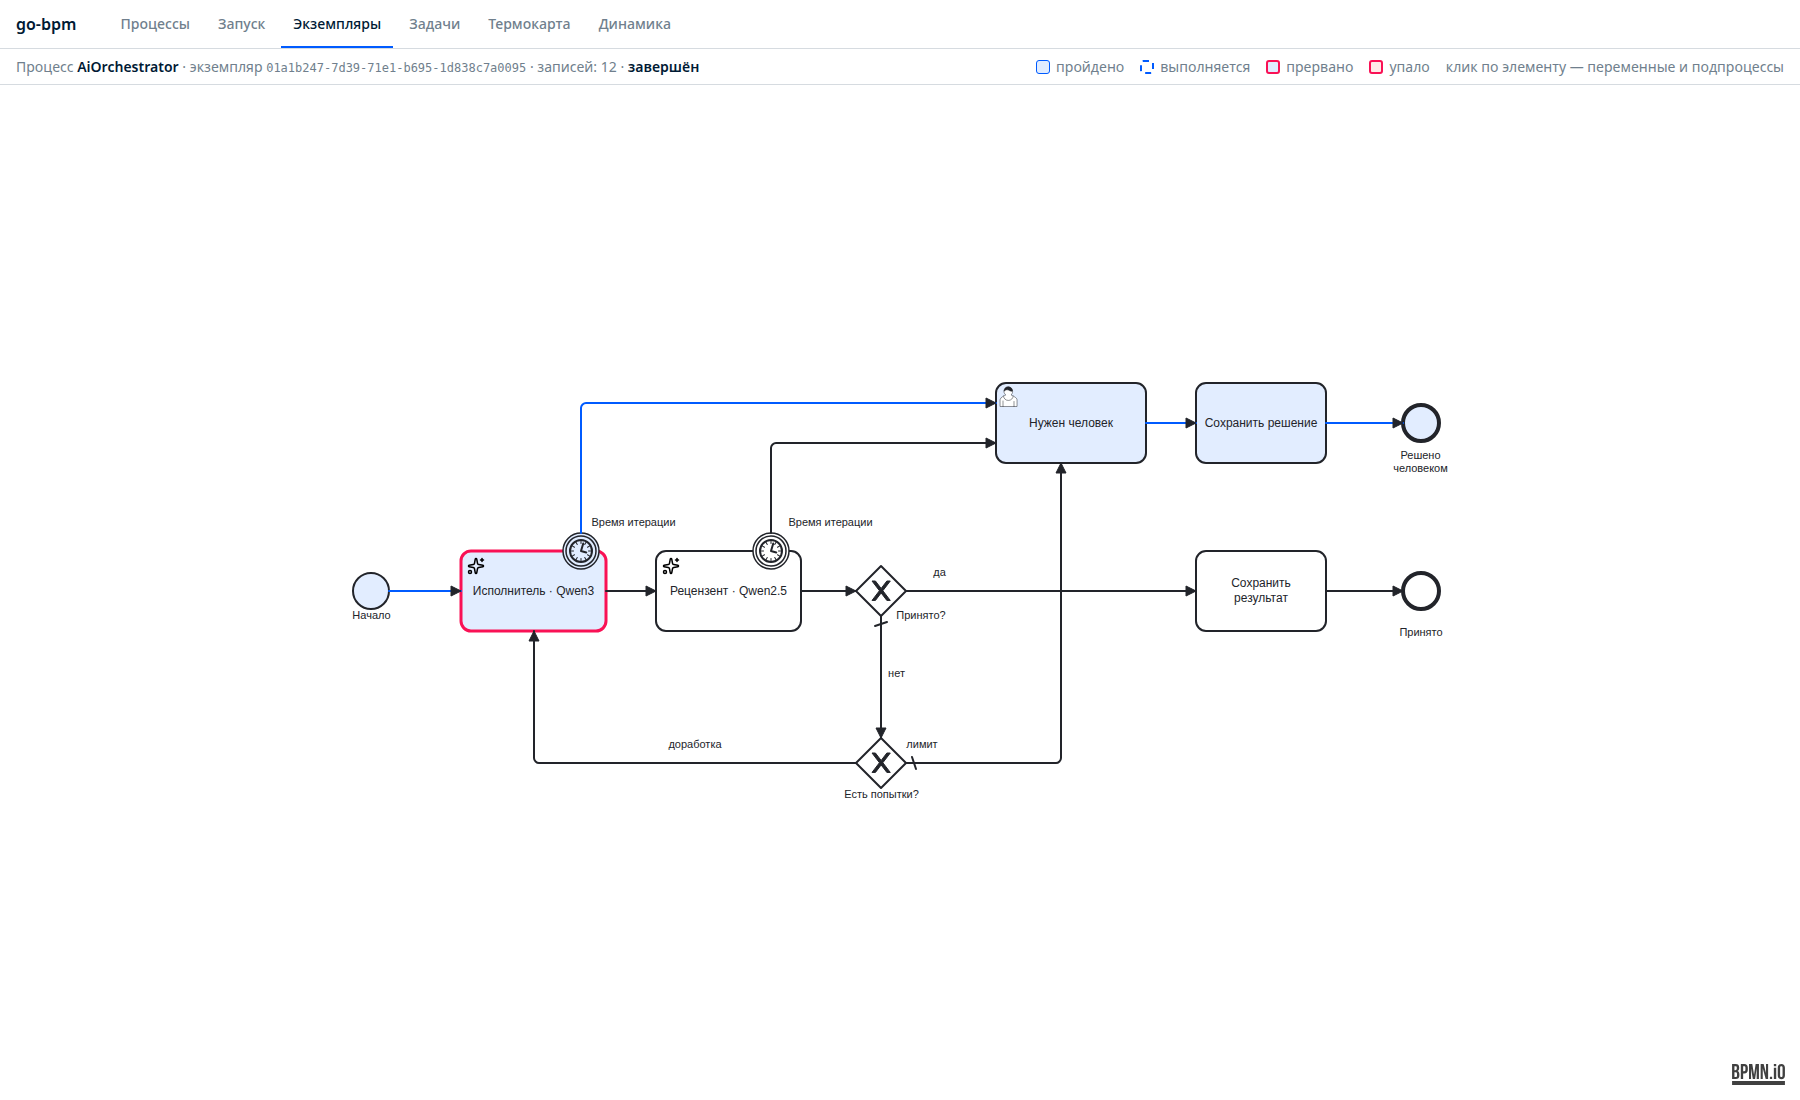
После завершения задачи метод «Сохранить решение» записывает окончательный исход, и процесс завершается. Ручное одобрение здесь завершает процесс; оно не запускает новую итерацию модели автоматически.
outcome | Смысл | Статус экземпляра |
|---|---|---|
accepted | Решение одобрил LLM-рецензент | completed |
needs_human | Ожидается решение человека | running |
approved_by_human | Человек принял результат | completed |
rejected_by_human | Человек отклонил результат | completed |
Для ручного одобрения нужно передать humanApproved: true. Если флаг не передан,
используется его значение из переменных процесса; в штатном запуске это false.
Технический сбой с исчерпанными повторами имеет отдельный статус failed.
Почему одобрение второй модели ещё не означает, что код работает#
В другом прогоне запросили функцию Go UniqueSorted: уникальные числа по возрастанию,
без изменения исходного среза (последовательности чисел). Для nil и пустого ввода функция должна
возвращать пустой срез []int{}. Ещё попросили тесты с набором входных данных и ожидаемых ответов.
На первой итерации исполнитель ошибся в вызове copy, рецензент вернул замечание.
На второй исполнитель поменял порядок аргументов, и рецензент ответил approved: true.
Процесс завершился с round: 2, outcome: accepted.
Но в принятом решении осталось:
copy := make([]int, len(values))
copy(copy, values)
В Go уже есть встроенная функция copy, которая копирует элементы одного среза в другой.
Но первая строка создаёт переменную с тем же именем. Во второй строке программа пытается вызвать
эту переменную как функцию. Так сделать нельзя.
Мы вынесли полученный код в отдельный временный Go-модуль и проверили командой go build ./....
Компилятор нашёл ошибку:
./main.go:17:5: invalid operation: cannot call copy (variable of type []int): []int is not a functionКроме того, рецензент заявил, что тесты проверяют неизменность входного среза, хотя явной проверки в ответе нет. Программа не запускалась: проверялась именно компиляция в отдельном временном модуле.
acceptedозначает согласие LLM-рецензента. Это не подтверждение компиляции или прохождения тестов. Чтобы доверять коду больше, следующим шагом нужно добавить сборку и запуск тестов в отдельной изолированной среде.
Полная история двух итераций · Принятый Go-блок без исправления ошибки.
Как запустить пример у себя#
Репозиторий самостоятельный: движок, генератор, API и консоль скопированы из go-bpm, исходные демопримеры удалены. Скачивать рядом отдельную копию движка для сборки не нужно. Нужны доступная Ollama с установленными моделями и отдельная PostgreSQL.
В проекте есть конфигурация Docker Compose:
git clone https://github.com/nicolas-vp/go-bpm-ai-orchestrator.git
cd go-bpm-ai-orchestrator
cp .env.example .env
# Задайте POSTGRES_PASSWORD и доступный из контейнера OLLAMA_URL.
# WRITER_MODEL и REVIEWER_MODEL должны соответствовать моделям в вашей Ollama.
docker compose up -d --build
Имена qwen3-coder:30b-32k и qwen2.5-coder:32b-8k — локальные теги настроенных моделей нашего стенда.
Для другого сервера задайте свои имена. Консоль будет на http://localhost:8092/ui/;
порты Compose опубликованы только на localhost, база и том — собственные.
Чтобы увидеть таймаут, отправьте длинное задание с коротким сроком:
curl -fsS -X POST http://localhost:8092/api/v1/processes/AiOrchestrator/instances \
  -H 'Content-Type: application/json' \
  -d '{"businessKey":"timeout-example","variables":{"goal":"Write a complete Go implementation of a bounded concurrent LRU cache, with extensive tests and explanation of all concurrency edge cases.","aiTimeoutSeconds":5}}'
В ответе — id. Откройте /ui/history/?instanceId=<id> на своём стенде.
Если генерация займёт дольше 5 секунд, появится задача человека. Во вкладке «Задачи» укажите пользователя reviewer,
группу reviewers, возьмите задачу и завершите её с решением.
Короткий запрос модель может успеть выполнить до таймера — сам таймер не добавляет искусственную задержку.
В описанном эксперименте проверен локальный запуск из Go и работа с PostgreSQL. Образ и запуск через Compose в этом прогоне не проверялись.
Как мы проверяли сам процесс#
Помимо запусков с настоящими моделями, есть автоматические тесты. В них вместо модели отвечает заранее подготовленный обработчик: так можно точно воспроизвести нужную ситуацию. С PostgreSQL и детектором гонок Go проходят шесть сценариев: принятие моделью сразу, доработка и принятие, лимит с ручным принятием, лимит с ручным отклонением, таймаут исполнителя и таймаут рецензента. В тестах таймаута ответ модели удерживается до завершения ручного решения, затем обработчик освобождается. Проверяется, что поздний ответ не меняет исход и комментарий, а активных таймеров после завершения не остаётся. Эти тесты используют детерминированные ответы; живые модели проверены отдельно в описанных прогонах.
Также прошли генерация, сборка, go vet и CI. Состояние пережило перезапуск приложения:
после восстановления Ollama упавшую задачу повторили в том же экземпляре.
Все снимки сделаны с работающего приложения. Схема и исходный код статьи соответствуют версии
4ff7fd1 от 6 ноября 2026 года.
Разобрать код и повторить эксперимент · AI task в справочнике BPMN · Задачи пользователей и API · Тестирование процессов.